ブラウザで動くボイスクローンの記事を書きながら、小さなモデルを使ってブラウザでどこまでできるのか、興味を持ちました。
趣味でSwiftの音楽再生アプリも作っていたため、その体験をブラウザでも実現できないか試して、HTMLのDJアプリを公開しました。自分の音源を読み込み、2台のレコードプレーヤーで再生できるRemixです。
曲を分析して、自動でつなぐ
まずは曲をつなぐために、音の立ち上がりや周波数の分布からBPMやキー、曲中の盛り上がりを推定しました。その情報を使い、Remixが曲順と切り替える場所を選びます。
Auto blendをオンにすると、読み込んだ曲を次々につないで再生できます。BGMとして流しているうちに、もっと曲の中身を使ってつなぎたくなりました。
そこで、AppleのMusic Understandingのように曲を詳しく解析し、ブラウザで音をパートごとに分けられないか試してみました。
音を4パートに分ける
ボーカル、ドラム、ベース、その他の音を取り出すために、HTDemucs、Spleeter、Open-Unmix、SCNetのオープンソースモデルを試しました。分離した音を聴き比べると、私にはSCNetがいちばんよく聞こえました。
まずはその結果を聴いてみてください。
分離した音を聴いてみる
サンプル曲「Stay A Little」の4パートを組み合わせて聴けます。PCでは自分の曲を選んでブラウザで分離し、各パートをダウンロードできます。音源はサーバーに送られません。
12.9 MBのモデルなのに、5分かかった
使ったSCNetのモデルは12.9 MB。これなら軽そうです。ところがブラウザで動かすと、1曲の分離に5分以上かかることがありました。タブのメモリ使用量も、ある時点で1.9 GBに達しました。
モデルのファイルは小さくても、実行時には計算とメモリが必要です。しかもSCNetは、1区間の4パートをまとめて計算します。ボーカルだけ先に書き出しても、曲全体のボーカルが早く完成するわけではありません。
SCNetはどうやって音を分ける? 概念図とモデル構造
音を時間と周波数のデータに変換し、SCNetで圧縮・分離した後、4つの波形に戻します。
エンコーダーで縮めた特徴を、分離ネットワークが時間と周波数の両方向から処理します。デコーダーは、圧縮前から引き継いだ情報も使って、4パートの周波数データを一度に出力します。
並んだデータを順に読み、周囲の情報を手がかりに特徴を捉えるニューラルネットワークです。
たとえば歌声は、ひとつの瞬間だけでなく、音程や声の響きが時間に沿って続きます。SCNetは時間方向のLSTMで前後を見比べ、続いている音の特徴を捉えます。
ひとつの音は、基本の高さだけでなく、複数の高さに同時に響きます。周波数方向のLSTMは、そのような高さの間の関係を調べます。SCNetは各方向を双方向に読み、処理中の区間の前後の情報を使います。
実際のモデルの層構造を見る scnet.int8.onnx · 12.9 MB
今回使ったモデルの推論経路です。各ブロックを開くと、層とその役割を見られます。数字は1区間を処理するときの形状です。
ステレオの実部・虚部を4チャンネルに並べた周波数データ
逆STFTでドラム・ベース・その他・ボーカルの波形に戻す
ENCODER 14 → 32 ch2,049 → 616 bands
周波数を低・中・高の3帯域に分け、異なる割合で圧縮します。畳み込みで各帯域の特徴も取り出します。
DECODER 332 → 16 ch616 → 2,049 bands
対応するエンコーダーの特徴を融合し、帯域を元の周波数解像度へ戻します。16チャンネルは4パート × ステレオ × 実部・虚部です。
ENCODER 232 → 64 ch616 → 186 bands
さらに周波数方向を圧縮し、複数の畳み込みを通します。ここで得た特徴はデコーダー2にも渡されます。
DECODER 264 → 32 ch186 → 616 bands
エンコーダー2の特徴と融合し、帯域ごとの転置畳み込みで周波数方向を広げます。
ENCODER 364 → 128 ch186 → 57 bands
圧縮された特徴は、128チャンネル × 57周波数位置 × 476フレームになります。
DECODER 1128 → 64 ch57 → 186 bands
分離ネットワークの出力を、エンコーダー3の特徴と融合します。その後、帯域ごとにアップサンプリングします。
エンコーダー3から ↓
BLOCK 1BiLSTM × 2hidden 128 → RFFT
57の周波数位置と476フレームを、それぞれ別の軸として処理します。続くRFFTで特徴の表現を変換します。
BLOCK 2BiLSTM × 2hidden 256 → IRFFT
変換後の表現を処理し、逆変換で元の時間軸の表現へ戻します。
BLOCK 3BiLSTM × 2hidden 128 → RFFT
時間方向と周波数方向の依存関係を、別々の双方向LSTMで捉えます。
BLOCK 4BiLSTM × 2hidden 256 → IRFFT
変換された表現で同じ2方向の処理を行い、逆変換します。
BLOCK 5BiLSTM × 2hidden 128 → RFFT
圧縮された特徴を、周波数方向と時間方向の両方から再び調べます。
BLOCK 6BiLSTM × 2hidden 256 → IRFFT
最後の2つの双方向LSTMを通し、逆変換した特徴をデコーダーへ渡します。
↑ デコーダー1へ
モデルの入出力とLSTMは、実際のONNXを分割した実行グラフから確認しました。行列の形は「バッチ × チャンネル × 周波数 × フレーム」です。STFTと逆STFTはモデルの前後で実行します。使用したモデル · SCNetの論文
モデルを変えずに実行方法を見直す
学習済みの重みはそのまま使い、ブラウザでの計算方法を組み直しました。ONNX Runtimeのサブグラフと、WebGPU向けに書いたLSTMカーネルを組み合わせています。バッファの再利用や同期回数の削減には、ローカルLLMの高速化で使われる考え方も参考にしました。
MacのChromeで同じ入力を使い、モデルの推論1回にかかる時間を測りました。初期のWebGPU経路では約17.7秒、GPU実行経路を組み直した後は約1.7秒でした。改善後の値は、モデルを一度動かし、GPUの準備が済んだ後の「暖機済み」の試行です。
推論1回の時間が、およそ10分の1になりました。削れた約90%には、LSTMカーネルやバッファ再利用など、複数の変更が含まれています。
CPU処理も見直しました。Nodeでモデルを模擬した別の試験では、バッファ再利用などにより、CPU処理時間が約13%短くなりました。
推論後には周波数のデータから音声を再構成する処理もあります。暖機後に6秒の音源で測ると、逆FFTと重ね合わせをWebAssemblyに移したことで、この部分は約209ミリ秒から67ミリ秒になりました。処理全体では約105ミリ秒、約6%短くなりました。
ストリーミング再生
分析は速くなりましたが、すべて終わるまで待つのは体験としてよくありません。そこで、完成した区間から順番に再生するようにしました。
曲を重なり合う区間に分け、それぞれをSCNetに渡します。後の計算で変わらなくなった部分から、約5.5秒ずつ再生側へ渡します。4パートは同じ再生位置を共有するので、曲の途中でもボーカルやドラムを切り替えられます。
実装初期に60秒の音源で試すと、最初の区間は5.5秒で再生可能になりました。WAV全体の完成には40.7秒かかりました。後半を処理している間に、先にできた音を聴けるようになりました。
メモリも見直しました。再生中は近くの区間を保持し、完成した区間をブラウザ内のキャッシュに保存します。別の6秒のGPUバッファ測定では、解放方法を変えることで割り当てのピークが約1,317 MBから733 MBになりました。これはGPUバッファの値で、タブ全体のメモリ使用量とは別です。
2曲のパートを組み合わせる
分離できるようになると、DJアプリの使い方も変わりました。AのボーカルとBの伴奏を合わせたり、片方のドラムだけを入れ替えたりできます。分離した4パートは、波形でも表示します。
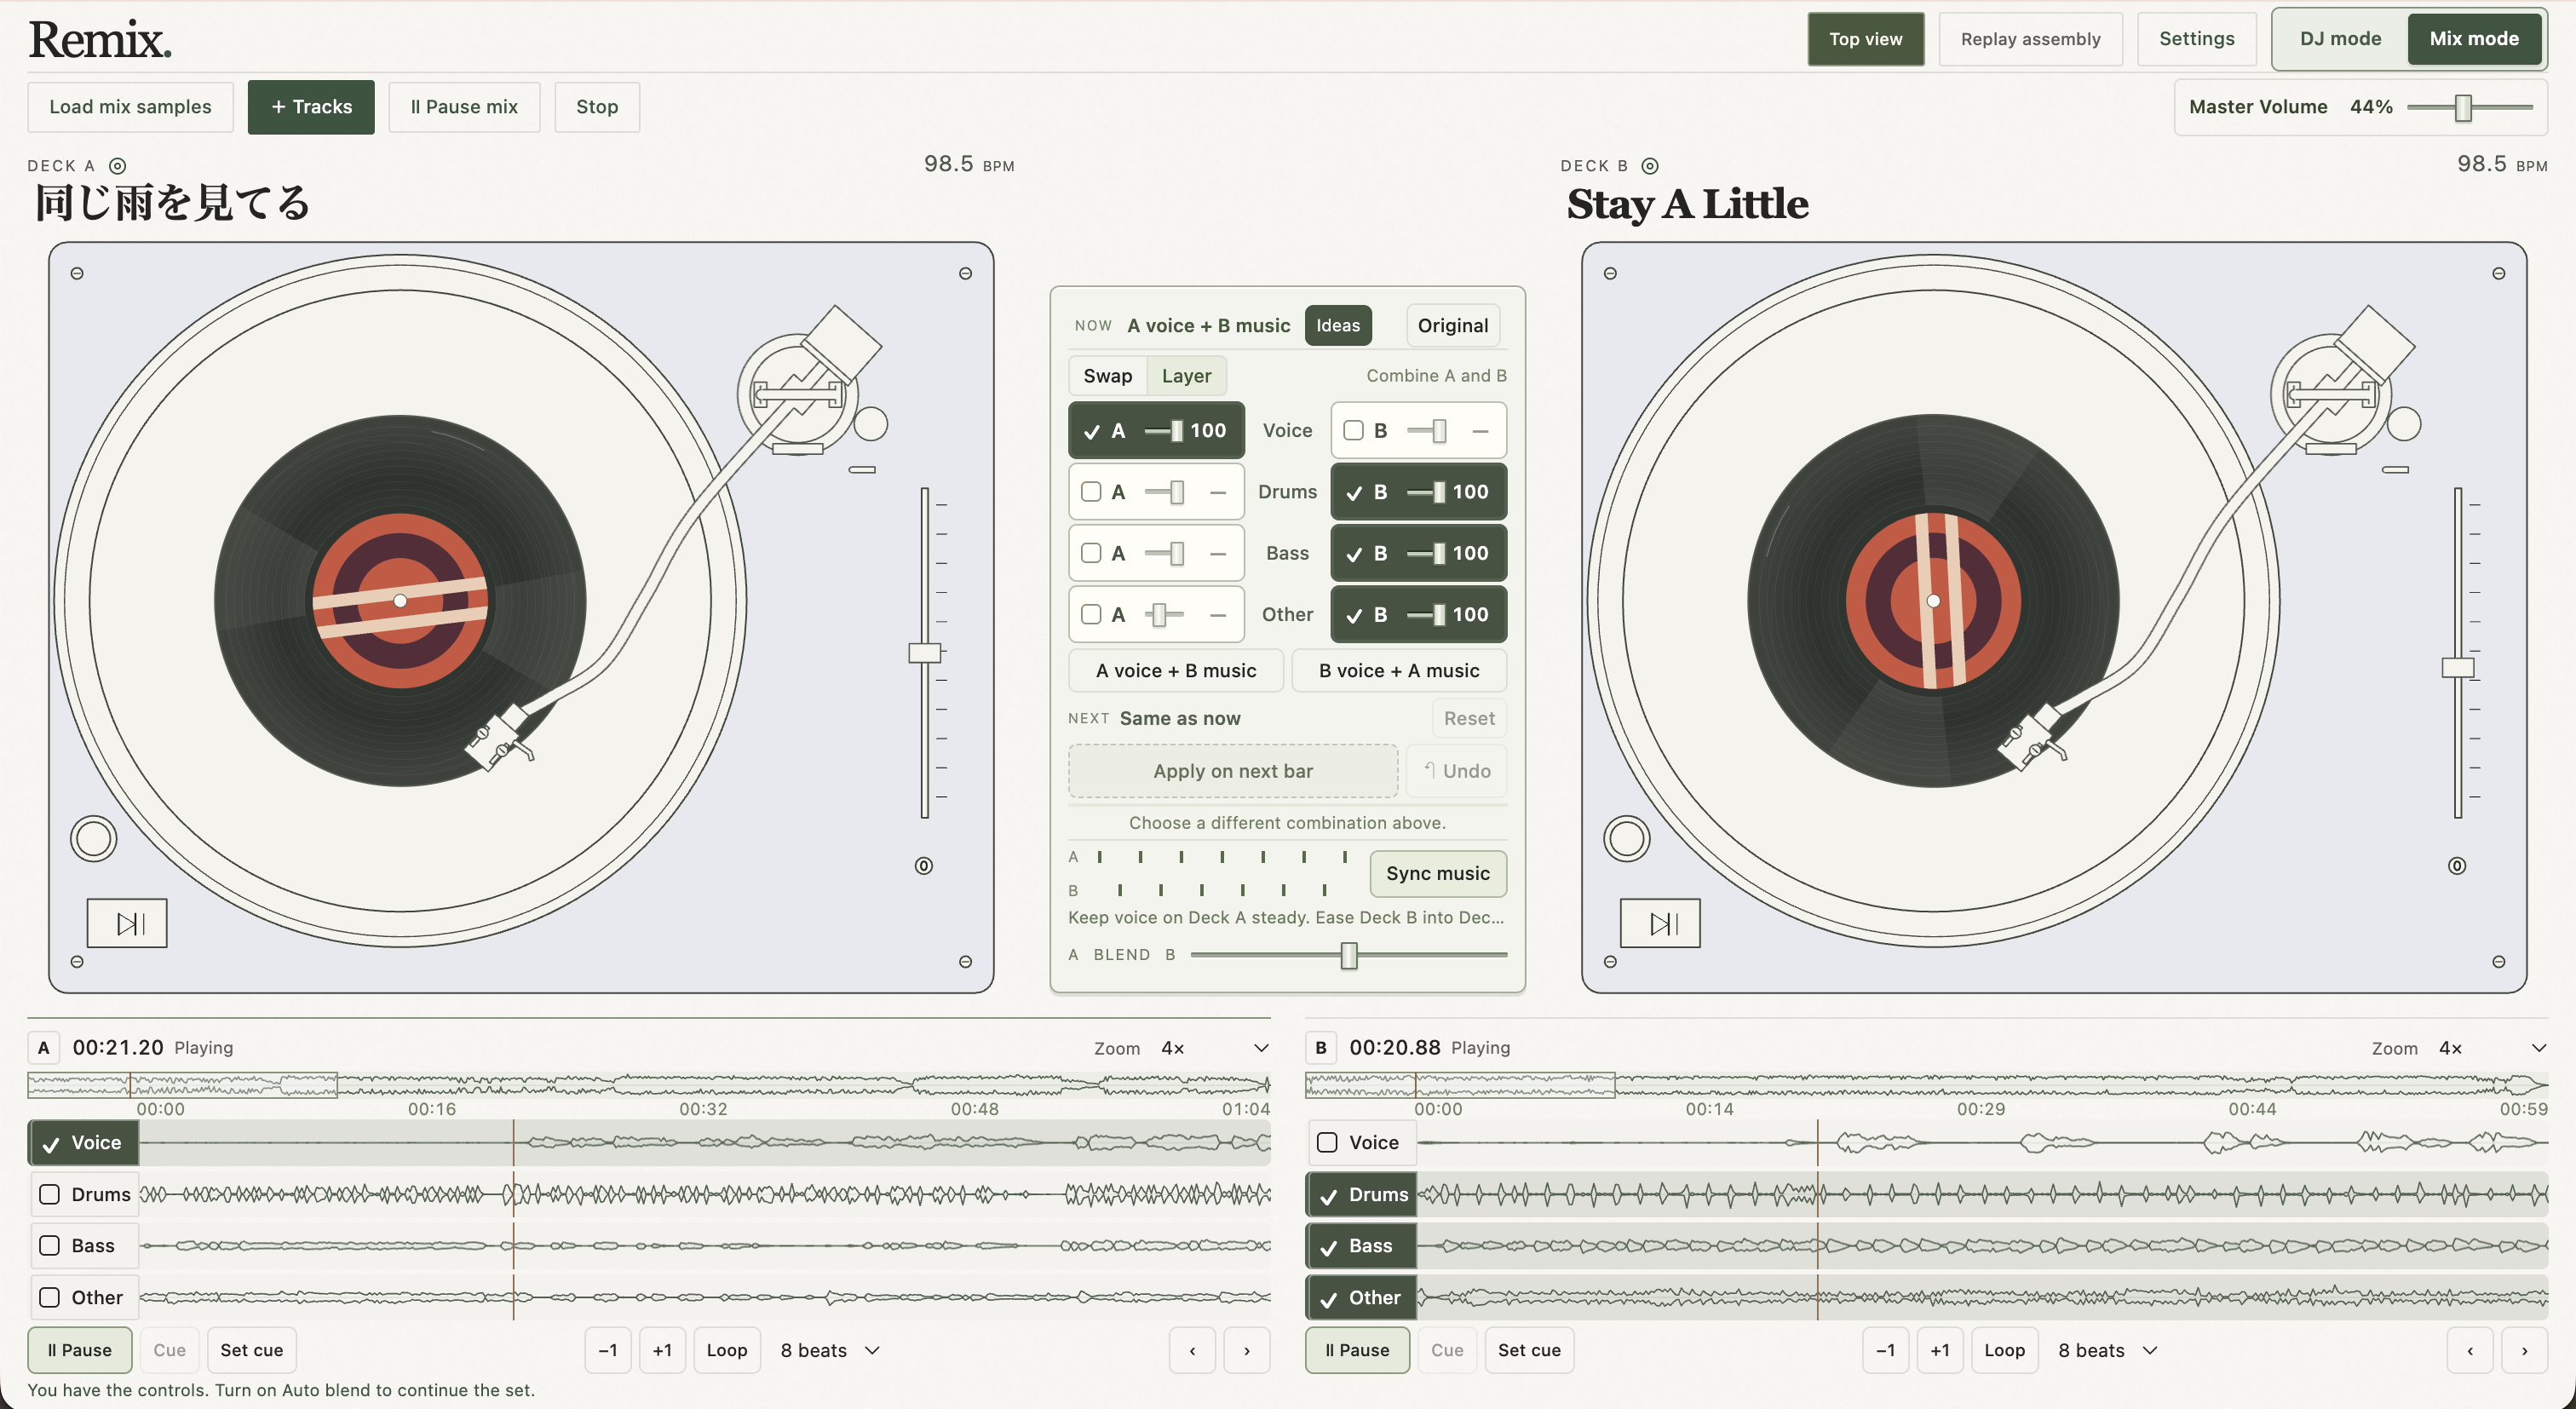
Auto blendでは曲全体を順番につないでいました。音を分離できるようになったことで、2曲のパートを組み合わせるマッシュアップも提案できるようになりました。
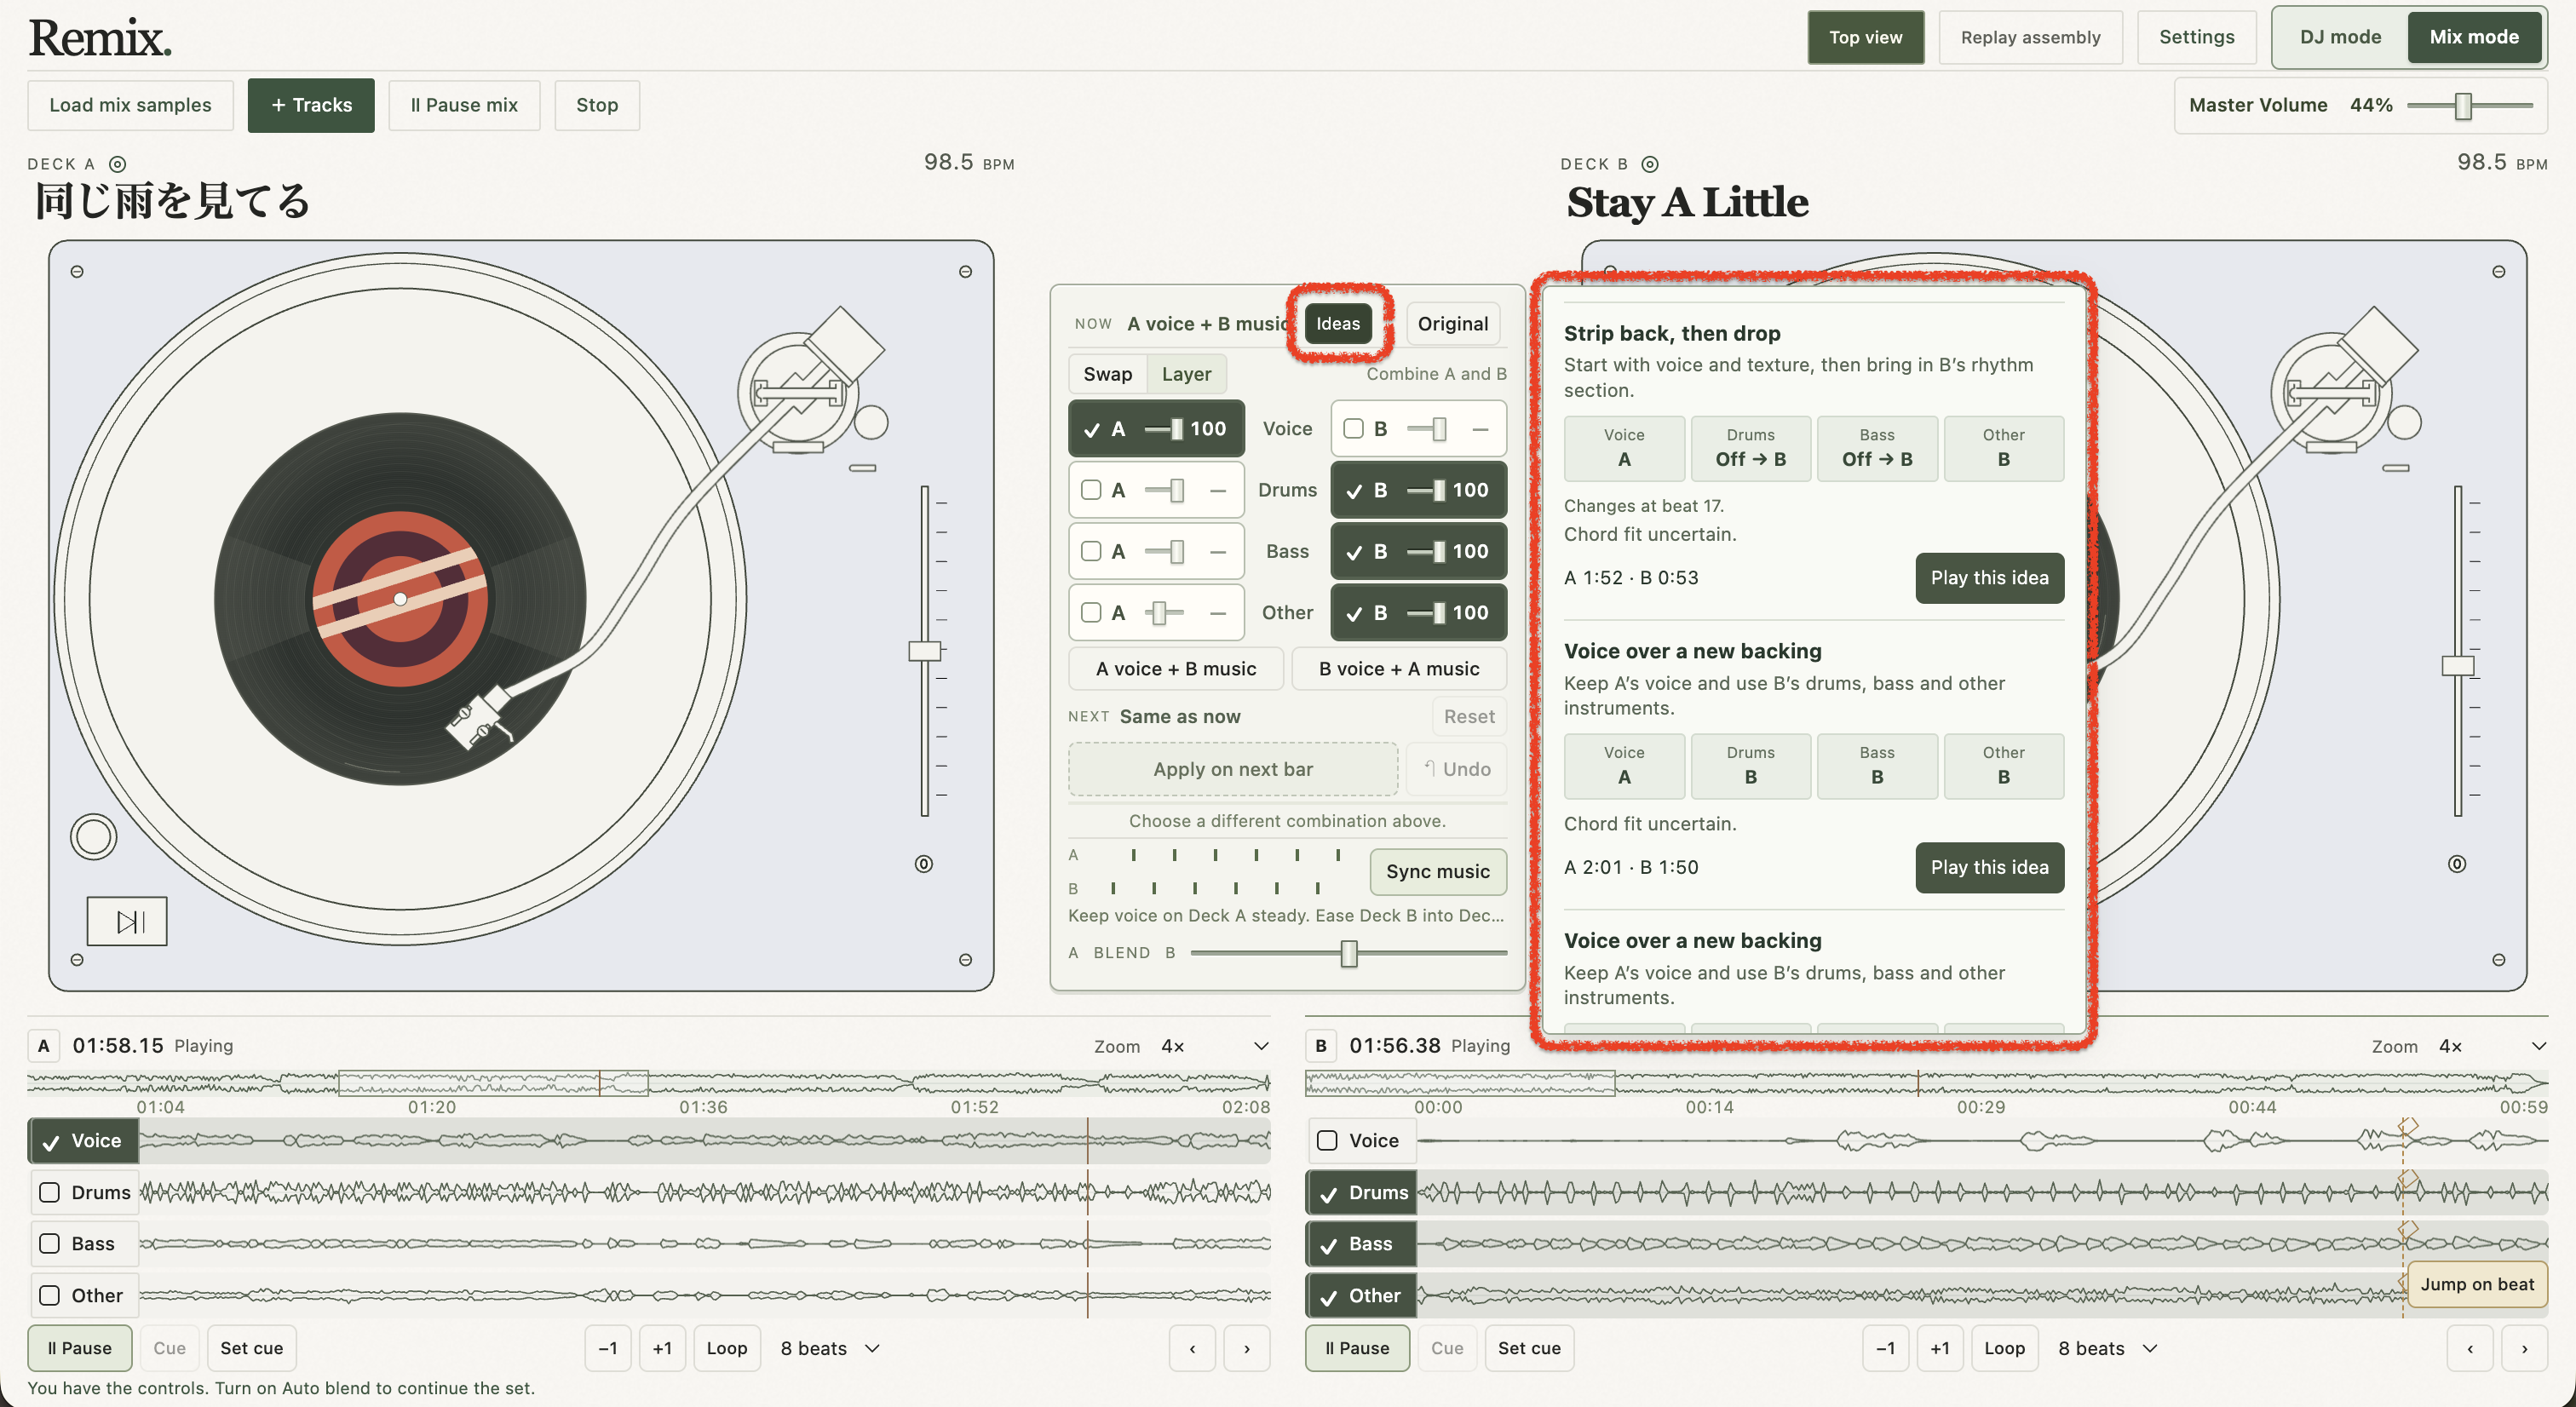
Mix Ideasは、BPMやキーから相性のよい曲を探し、分離が進んだ2曲については、各パートの活動量も使って組み合わせる区間やパターンを提案します。
スマートフォンではサンプルから
スマートフォンでリアルタイム分離を試したところ、クラッシュしました。そこで2曲をあらかじめ分離し、必要な区間だけを圧縮して読み込むサンプルを用意しました。
スマートフォンでは、その2曲を使ってMix modeを試せます。PCではサンプルに加えて、自分の音源も分離できます。
Remixを試すから、自分の音源やサンプルを読み込めます。自分だけのマッシュアップを作ったり、楽器の音を聴いて耳コピをしたり、カラオケを練習したりと、いろいろ楽しめると思います。